Gage R&R क्या है: 10% और 30% की शर्त, जापानी कस्टमर
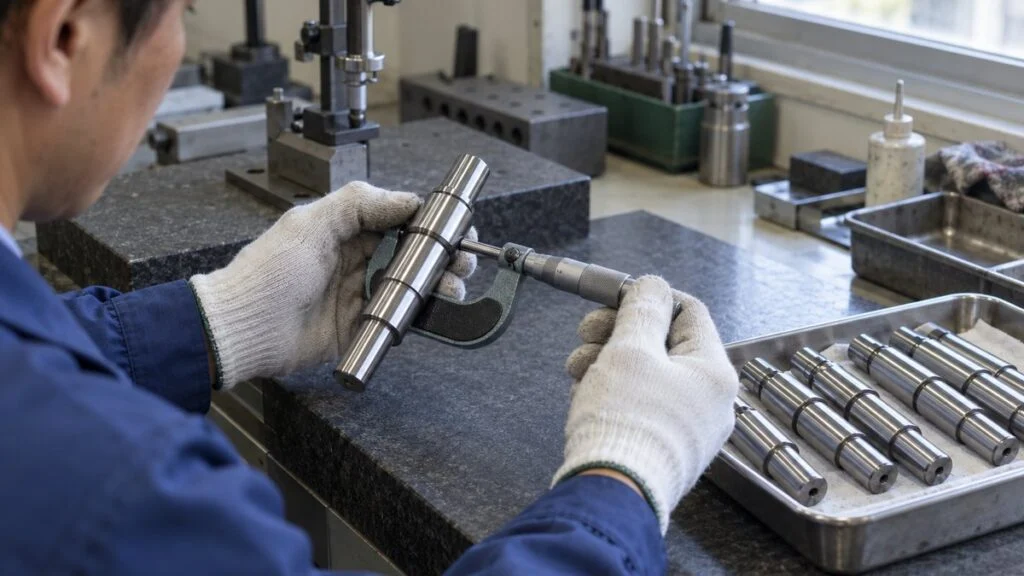
आपके गेज हर साल कैलिब्रेट होते हैं और सर्टिफ़िकेट फ़ाइल में लगे हैं। फिर जापानी कस्टमर की क्वालिटी टीम कहती है कि Gage R&R का रिज़ल्ट चाहिए, यानी sokutei shisutemu kaiseki (MSA, Measurement Systems Analysis)। जापानी कार कंपनियों और Tier 1 को पार्ट देने वाले सप्लायर, चाहे भारत में हों, थाईलैंड में या अमेरिका में, यह माँग कभी न कभी देख सकते हैं।
कैलिब्रेशन मुख्य रूप से एक ही चीज़ जाँचता है: गेज की रीडिंग रेफ़रेंस स्टैंडर्ड से कितनी हटी हुई है (bias)। असल नाप में बिखराव भी आता है, जब वही आदमी वही पार्ट दोबारा नापता है, और रीडिंग बदल भी जाती है, जब कोई दूसरा आदमी नापता है। Gage R&R इस बिखराव को नंबर में बताता है और उसे पार्ट-टू-पार्ट variation या टॉलरेंस से मिलाता है।
इस गाइड में हम देखेंगे कि MSA में Gage R&R की जगह कहाँ है, स्टडी के 6 स्टेप क्या हैं, और average and range तरीके का एक पूरा (काल्पनिक) उदाहरण। फिर ANOVA के नतीजे कैसे अलग दिखते हैं और 10% और 30% की शर्त कैसे पढ़ें। आख़िर में वे बातें हैं जो जापानी कस्टमर आम तौर पर देखते हैं, भेजने से पहले का चेकलिस्ट, और स्टडी करने से पहले पूछने वाले सवाल।
विषय-सूची
- MSA में Gage R&R क्या नापता है
- Gage R&R स्टडी के 6 स्टेप
- Average and Range तरीका: हल किया हुआ उदाहरण
- Average and Range बनाम ANOVA
- पास होने की शर्त: 10%, 30% और ndc ≥ 5 कैसे पढ़ें
- रिज़ल्ट ख़राब आए तो क्या करें
- गिनती वाला नहीं, पास/फ़ेल वाला MSA: Attribute MSA और Kappa
- रिपोर्ट भेजने से पहले: चेकलिस्ट और जापानी कस्टमर से सवाल
- इस गाइड की सीमाएँ
- अक्सर पूछे जाने वाले सवाल (FAQ)
- स्रोत (Sources)
MSA में Gage R&R क्या नापता है
MSA सिर्फ़ इंस्ट्रूमेंट को नहीं, पूरे नापने के सिस्टम (measurement system) को statistics से जाँचता है। इस सिस्टम में नापने वाला आदमी, नापने का तरीका, fixture और आसपास का माहौल, सब शामिल हैं। ऑटोमोबाइल इंडस्ट्री में असली स्टैंडर्ड AIAG (Automotive Industry Action Group, अमेरिका की ऑटो इंडस्ट्री संस्था) का MSA reference manual है। इसका मौजूदा edition चौथा (4th) है, जो जून 2010 में छपा था, और अक्टूबर 2026 तक AIAG यही edition दिखा रहा है।
मैन्युअल नापने के सिस्टम की गलती को दो तरह में बाँटता है। एक location error, यानी रीडिंग का औसत सही वैल्यू से हट जाना। दूसरा width (spread) error, यानी रीडिंग अपने औसत के आसपास बिखर जाना। Gage R&R width error को जाँचता है: एक ही चीज़ बार-बार नापने पर रीडिंग कितनी फैलती है।
तीन चीज़ें location error बताती हैं और दो width error। Gage R&R width वाली दोनों चीज़ों को मिलाकर देखता है।
EV = Equipment Variation; AV = Appraiser Variation। यह बँटवारा AIAG MSA मैन्युअल (4th edition) का सार बताने वाली जानकारी पर आधारित है।
Repeatability और Reproducibility: जापानी शब्दों पर एक बात
जापानी रिपोर्टों में repeatability को kurikaeshi-sei और reproducibility को saigen-sei लिखा जाता है। जापान के नापतोल शब्दों के स्टैंडर्ड JIS Z 8103 में repeatability वह precision है जो repeatability की शर्तों में आती है: वही तरीका, वही आदमी, वही नापने का सिस्टम, वही हालात और वही जगह, और कम समय में एक ही चीज़ का बार-बार नाप। Gage R&R इसी को EV के रूप में दिखाता है।
JIS में reproducibility का मतलब ज़्यादा चौड़ा है। उसकी शर्तों में अलग जगह और अलग नापने का सिस्टम भी आ सकते हैं। Gage R&R में reproducibility (AV) का मतलब मुख्य रूप से नापने वाला बदलने से आया फ़र्क है। अगर आपकी प्रोसेस शीट या रिपोर्ट किसी जापानी कस्टमर के पास जा रही है, तो साफ़ लिख दें कि "reproducibility = नापने वालों के बीच का फ़र्क", ताकि कोई इसे JIS के चौड़े मतलब में न पढ़ ले।
भारत में यही बात IS 15393 (Part 1 से 6, 2003) में आती है, जिसे BIS ने ISO 5725 (1994) के बराबर अपनाया है। इसमें repeatability और reproducibility की परिभाषाएँ ISO वाली हैं, यानी JIS जैसी चौड़ी, और Gage R&R वाले संकरे मतलब से अलग। इसलिए MSA रिपोर्ट में शब्द इस्तेमाल करते समय अपना मतलब लिख दें। ISO 5725-1 का नया (2023) edition भी आ चुका है, इसलिए BIS का कौन-सा edition चालू है, यह BIS से देख लें।
स्टडी में नापे गए पूरे variation को दो हिस्सों में बाँटा जाता है: पार्ट खुद के variation का हिस्सा और नापने के सिस्टम के variation का हिस्सा। नीचे का चित्र यह बँटवारा दिखाता है।
अच्छे नापने के सिस्टम में ज़्यादातर variation पार्ट का होता है और GRR छोटा होता है।
सिर्फ़ variance (standard deviation का वर्ग) जुड़ता है। Standard deviation और प्रतिशत को सीधे जोड़ा नहीं जा सकता।
कैलिब्रेशन और Gage R&R में फ़र्क
कैलिब्रेशन में गेज को traceable स्टैंडर्ड से मिलाकर देखा जाता है कि उसकी रीडिंग में कितना error है। यह सिर्फ़ इंस्ट्रूमेंट को देखता है, मुख्य रूप से चित्र 1 वाला bias। कैलिब्रेशन और traceability होने पर भी fixture में ढीलापन या नापने वाले की आदतें variation जोड़ती रहती हैं। जापानी प्लांटों में कैलिब्रेशन और traceability के रिकॉर्ड के लिए यह लेख देखें: ।
Gage R&R में असली पार्ट लिए जाते हैं, जिन्हें वही लोग नापते हैं जो रोज़ नापते हैं, और रोज़ वाले तरीके से। कैलिब्रेशन पूछता है "क्या गेज सही है?" Gage R&R पूछता है "क्या इस तरीके से पार्टों का फ़र्क पकड़ में आ सकता है?" नाप को क्वालिटी के फ़ैसलों में इस्तेमाल करने के लिए दोनों चाहिए।
जापानी ऑटो कस्टमर यह क्यों माँगते हैं: IATF 16949 की 7.1.5.1.1
ऑटोमोबाइल का क्वालिटी मैनेजमेंट स्टैंडर्ड IATF 16949 अपनी clause 7.1.5.1.1 में MSA माँगता है। कंट्रोल प्लान में लिखे हर तरह के inspection, measurement और test equipment सिस्टम के नतीजों के variation की statistical स्टडी करनी होती है। विश्लेषण का तरीका और पास होने की शर्त MSA reference manual के हिसाब से होनी चाहिए। दूसरा तरीका या शर्त तभी चलती है जब कस्टमर मंज़ूर करे, और उस मंज़ूरी का रिकॉर्ड रखना होता है।
यानी किन चीज़ों पर MSA करना है, यह कंट्रोल प्लान से तय होता है, और कस्टमर के अपने नियम AIAG के नंबरों जितने ही मायने रखते हैं। जापानी कस्टमर की लॉन्च प्रोसेस में MSA कहाँ आता है, इसके लिए देखें: और ।
Gage R&R स्टडी के 6 स्टेप
नतीजे पर कितना भरोसा हो, यह हिसाब से ज़्यादा डेटा लेने के तरीके पर टिका है। नीचे 10 पार्ट, 3 नापने वाले और हर एक के 3 trial वाला आम प्लान 6 स्टेप में बाँटा है।
तैयारी के तीन स्टेप ही काफ़ी हद तक तय करते हैं कि नतीजे पर भरोसा हो सकेगा या नहीं।
10 पार्ट, 2–3 नापने वाले और 2–3 trial आम तौर पर लिया जाने वाला अंदाज़ा है (Minitab technical paper)। कस्टमर ने कुछ तय किया हो तो वही मानें।
स्टेप 1: टारगेट और मक़सद तय करें
पहले तय करें कि कौन-सी क्वालिटी characteristic जाँचनी है, और किस गेज, fixture और तरीके से। IATF 16949 लागू हो तो आम तौर पर कंट्रोल प्लान में लिखे नापों से शुरू करते हैं।
यह भी तय करें कि वह नाप किस काम आता है: कंट्रोल चार्ट पर प्रोसेस का variation देखने के लिए, या भेजने से पहले pass/fail फ़ैसले के लिए। इसी से तय होगा कि आगे %GRR किस चीज़ से भाग देकर निकालेंगे।
स्टेप 2: रिज़ॉल्यूशन और कैलिब्रेशन देखें
गेज का रिज़ॉल्यूशन (least count, यानी सबसे छोटी पढ़ी जा सकने वाली रीडिंग) बहुत मोटा हो तो हर बार वही रीडिंग आती है, और variation ठीक से जाँचा नहीं जा सकता। AIAG की गाइडेंस में "10-to-1 rule" है: रिज़ॉल्यूशन टॉलरेंस का दसवाँ हिस्सा या उससे बारीक हो। 0.10 mm टॉलरेंस वाले साइज़ के लिए ऐसा गेज चाहिए जो 0.01 mm या उससे बारीक पढ़े।
देखें कि गेज की कैलिब्रेशन चालू है। Gage R&R bias नहीं जाँचता, इसलिए जिस गेज की कैलिब्रेशन की तारीख़ निकल चुकी है, उससे अच्छा रिज़ल्ट आ भी जाए तो इसका मतलब यह नहीं कि रीडिंग सही हैं।
स्टेप 3: पार्ट चुनें
ऐसे पार्ट चुनें जो प्रोसेस से असल में निकलने वाले variation की पूरी रेंज को कवर करें। Minitab के मुताबिक प्रोसेस की पूरी रेंज से पार्ट लेने पर पार्ट-टू-पार्ट variation का अंदाज़ा बेहतर लगता है। अगर एक ही लॉट से मिलते-जुलते पार्ट उठा लिए, तो पार्ट variation घट जाता है और %GRR बेवजह ख़राब दिखता है।
पार्टों पर नंबर लगाएँ, पर नापने वालों से छुपाकर रखें। जिसे नंबर दिखता है, वह पिछली रीडिंग याद रखकर वैसी ही रीडिंग लिख देता है। इसलिए नंबर पार्ट के नीचे की तरफ़ लगाएँ, या कोई दूसरा आदमी पार्ट पकड़ाए। 10 पार्ट से पार्ट variation का अंदाज़ा बहुत पक्का नहीं बनता। Minitab के technical paper में दो रास्ते दिए हैं: ज़्यादा पार्ट लें, या पुराने ढेर सारे डेटा से निकला प्रोसेस का standard deviation इस्तेमाल करें।
स्टेप 4: Random क्रम में नापें
नापने वाले उन्हीं लोगों में से चुनें जो यह नाप रोज़ करते हैं। सिर्फ़ सबसे अच्छे इंस्पेक्टर को लिया तो स्टडी रोज़ के नाप का variation कम बताएगी।
पहले trial में नापने वाला A सारे 10 पार्ट एक-एक बार नापता है, फिर B और C वैसे ही नापते हैं। दूसरे और तीसरे trial में पार्टों का क्रम बदलकर यही दोहराते हैं। हर trial में क्रम random रखने और पहले के नतीजे छुपाने से याद और नापने के क्रम का असर हट जाता है। पहले से तय कर लें कि पार्ट पर ठीक कहाँ नापना है, और सब वही जगह नापें।
स्टेप 5 और 6: हिसाब और फ़ैसला
डेटा आने के बाद हिसाब average and range तरीके या ANOVA से करें। Spreadsheet में हो सकता है, पर statistical software में ANOVA के नतीजे और ग्राफ़ एक बार में मिल जाते हैं।
फ़ैसले के लिए %GRR और ndc (number of distinct categories) को शर्तों से मिलाएँ। पास न हों तो देखें कि repeatability बड़ी है या reproducibility, और उसी हिसाब से एक्शन लें। अगले हिस्से में हिसाब स्टेप-दर-स्टेप दिखाया है।
Average and Range तरीका: हल किया हुआ उदाहरण
नीचे का डेटा काल्पनिक है। सारे नंबर समझाने के लिए बनाए गए हैं और किसी असली प्रोसेस के नहीं हैं। सेटअप यह है: शाफ़्ट का आउटसाइड डायमीटर, स्पेसिफ़िकेशन 10.00 ±0.05 mm (टॉलरेंस की चौड़ाई 0.10 mm), माइक्रोमीटर से नापा, जिसका least count 0.001 mm है। नापने वाले A, B और C हर एक 10 पार्ट तीन-तीन बार नापते हैं।
| नापने वाला / trial | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| A, trial 1 | 9.972 | 9.986 | 10.020 | 9.995 | 10.029 | 9.962 | 10.008 | 9.994 | 10.014 | 10.000 |
| A, trial 2 | 9.973 | 9.986 | 10.021 | 9.995 | 10.030 | 9.967 | 10.004 | 9.989 | 10.009 | 9.998 |
| A, trial 3 | 9.966 | 9.984 | 10.017 | 9.999 | 10.030 | 9.964 | 10.000 | 9.988 | 10.015 | 10.002 |
| A, range | 0.007 | 0.002 | 0.004 | 0.004 | 0.001 | 0.005 | 0.008 | 0.006 | 0.006 | 0.004 |
| B, trial 1 | 9.969 | 9.986 | 10.020 | 9.998 | 10.035 | 9.965 | 10.010 | 9.995 | 10.015 | 10.004 |
| B, trial 2 | 9.974 | 9.987 | 10.019 | 10.000 | 10.036 | 9.962 | 10.013 | 9.992 | 10.015 | 10.010 |
| B, trial 3 | 9.976 | 9.983 | 10.023 | 10.002 | 10.031 | 9.969 | 10.010 | 9.994 | 10.021 | 10.002 |
| B, range | 0.007 | 0.004 | 0.004 | 0.004 | 0.005 | 0.007 | 0.003 | 0.003 | 0.006 | 0.008 |
| C, trial 1 | 9.969 | 9.980 | 10.017 | 9.990 | 10.024 | 9.960 | 10.007 | 9.989 | 10.007 | 9.996 |
| C, trial 2 | 9.970 | 9.975 | 10.016 | 9.994 | 10.030 | 9.963 | 10.003 | 9.985 | 10.010 | 10.003 |
| C, trial 3 | 9.967 | 9.980 | 10.018 | 9.994 | 10.025 | 9.958 | 10.004 | 9.985 | 10.014 | 10.000 |
| C, range | 0.003 | 0.005 | 0.002 | 0.004 | 0.006 | 0.005 | 0.004 | 0.004 | 0.007 | 0.007 |
| पार्ट का औसत | 9.9707 | 9.9830 | 10.0190 | 9.9963 | 10.0300 | 9.9633 | 10.0066 | 9.9901 | 10.0133 | 10.0017 |
Average and range तरीका range (सबसे बड़ी घटा सबसे छोटी रीडिंग) और औसतों के फ़र्क से standard deviation का अंदाज़ा लगाता है। Range को standard deviation में बदलने वाले factor K1, K2 और K3 हैं, और इनकी वैल्यू trial, नापने वालों और पार्टों की गिनती पर निर्भर करती है।
तीन range या फ़र्क को K factor से standard deviation में बदलें, फिर उन्हें मिलाएँ।
n = पार्टों की गिनती, r = trial की गिनती। Factor AIAG MSA 4th edition के तरीके वाले हैं, SPC for Excel से और d2 व d2* की टेबल से निकली वैल्यू (K1 = 1/d2, K2 और K3 = 1/d2*) से मिलाकर देखे गए। 2–10 पार्ट के लिए K3: 0.7071, 0.5231, 0.4467, 0.4030, 0.3742, 0.3534, 0.3375, 0.3249, 0.3146।
पुरानी किताबों और कंपनी के पुराने spreadsheet में कभी-कभी 4.56 और 3.05 जैसे factor मिलते हैं। ये मैन्युअल के पहले और दूसरे edition के हैं, जिनमें नतीजा 99% spread (5.15 standard deviation) में लिखा जाता था। कुल variation के मुक़ाबले %GRR वही रहता है, पर EV और AV की असली वैल्यू और टॉलरेंस से अनुपात बदल जाते हैं। कोई भी template, चाहे कंपनी का अपना हो या पुराना, इस्तेमाल करने से पहले देखें कि वह किस edition के factor लेता है।
1. Repeatability (EV)
पहले हर नापने वाले के range का औसत निकालें। उदाहरण में A का 0.0047 mm, B का 0.0051 mm और C का 0.0047 mm है, इसलिए कुल औसत range R̿ 0.00483 mm (4.83 µm) है। पढ़ने में आसानी के लिए आगे का उदाहरण µm में है।
आगे बढ़ने से पहले देखें कि कोई भी range कंट्रोल लिमिट (UCL = D4 × R̿; 3 trial के लिए D4 = 2.574, यानी 12.4 µm) से बाहर तो नहीं। बाहर हो तो नापने या लिखने की गलती मानें और उस पार्ट को दोबारा नापकर ही हिसाब करें। यहाँ सबसे बड़ा range 8 µm है, तो सब ठीक है। तीन trial के लिए K1 = 0.5908 लेकर EV = 4.83 × 0.5908 ≈ 2.86 µm आता है।
2. Reproducibility (AV)
हर नापने वाले की 30 रीडिंग का औसत A का 9.99723 mm, B का 10.00053 mm और C का 9.99443 mm है। सबसे बड़े (B) और सबसे छोटे (C) का फ़र्क X̄diff 6.10 µm है। तीन नापने वालों के लिए K2 = 0.5231 है।
X̄diff × K2 = 3.19 µm है, जिसका वर्ग 10.18 है। नापने वालों के औसत में repeatability का थोड़ा variation भी घुला है, इसलिए EV² ÷ (10 पार्ट × 3 trial) = 2.86² ÷ 30 ≈ 0.27 घटाएँ। तब AV = √(10.18 − 0.27) ≈ 3.15 µm आता है। वर्गमूल के अंदर की वैल्यू माइनस आ जाए तो AV = 0 रखें।
3. GRR, PV और TV
GRR, EV और AV के वर्गों के जोड़ का वर्गमूल है: √(2.86² + 3.15²) ≈ 4.25 µm। Part variation PV, Rp से निकलता है, यानी सबसे बड़े पार्ट औसत (10.0300 mm) और सबसे छोटे (9.9633 mm) का फ़र्क। Rp = 66.67 µm है; 10 पार्ट के K3 = 0.3146 से गुणा करने पर PV = 20.97 µm आता है। Total variation TV = √(4.25² + 20.97²) ≈ 21.40 µm है।
4. %GRR और ndc
%GRR = 4.25 ÷ 21.40 × 100 ≈ 19.9%। इसी हिसाब से %EV = 13.3%, %AV = 14.7% और %PV = 98.0% आते हैं। %EV और %AV को जोड़ने से 19.9% नहीं बनता, क्योंकि सिर्फ़ वर्ग किए हुए नंबर (variance) जुड़ते हैं, जैसा चित्र 2 के नीचे लिखा है।
ndc = 1.41 × 20.97 ÷ 4.25 ≈ 6.96 है, जिसे नीचे गोल करके 6 लेते हैं। यहाँ 1.41, √2 का गोल किया हुआ रूप है।
%GRR 19.9% है, यानी "शर्त के साथ पास" वाले दायरे में। Reproducibility (AV) repeatability से थोड़ी बड़ी है।
काल्पनिक डेटा का उदाहरण; हिसाब Python में जाँचा गया। अनुपात वर्गों के जोड़ से मिलते हैं, इसलिए 13.3% + 14.7% का जोड़ 19.9% नहीं होता।
Average and Range बनाम ANOVA
ANOVA (analysis of variance) रीडिंग के variation को चार स्रोतों में बाँटता है: पार्ट, नापने वाले, नापने वाले और पार्ट की interaction, और repeatability error। AIAG मैन्युअल में दोनों तरीके दिए हैं, और statistical software में आम तौर पर ANOVA डिफ़ॉल्ट होता है।
Minitab के मुताबिक average and range तरीका नापने वाले और पार्ट की interaction का variance नहीं निकाल सकता। Interaction का मतलब है कि नापने वालों का फ़र्क हर पार्ट पर अलग है, जैसे "नापने वाला C सिर्फ़ छोटे पार्टों पर कम रीडिंग लेता है।" ANOVA आम तौर पर variance का अंदाज़ा ज़्यादा सटीक लगाता है और यह भी जाँच सकता है कि interaction है या नहीं।
X̄-R तरीका हाथ से किया जा सकता है। ANOVA ज़्यादा जानकारी और ज़्यादा सटीक अंदाज़ा देता है।
उदाहरण के ANOVA में interaction का p-value 0.75 आया, इसलिए interaction हटाकर मॉडल दोबारा निकाला गया (Minitab, p ≥ 0.05 होने पर interaction हटा देता है)।
उसी काल्पनिक डेटा को ANOVA से चलाने पर repeatability का standard deviation 2.63 µm, reproducibility का 3.02 µm, GRR का 4.00 µm और पार्ट-टू-पार्ट का 21.12 µm आता है। %GRR (standard deviation के अनुपात में) 18.6% है और ndc 7 है। नंबर थोड़े अलग इसलिए हैं कि एक तरीका range से और दूसरा mean square से अंदाज़ा लगाता है, पर दोनों एक ही दायरे में आते हैं।
Software का आउटपुट पढ़ते समय %Contribution (जापानी रिपोर्ट में kiyo-ritsu) और %Study Var (kenkyu hendo) को आपस में न मिलाएँ। %Contribution variance का अनुपात है: उदाहरण में GRR के लिए 3.5%। %Study Var standard deviation का अनुपात है: 18.6%। 10% और 30% की शर्तें standard deviation के अनुपात (%Study Var या टॉलरेंस से अनुपात) के लिए हैं। %Contribution के लिए Minitab की अलग गाइडलाइन है: 1% से कम, 1–9%, और 9% से ऊपर।
पास होने की शर्त: 10%, 30% और ndc ≥ 5 कैसे पढ़ें
AIAG MSA मैन्युअल की सबसे जानी-मानी शर्तें %GRR को 10% और 30% पर तीन दायरों में बाँटती हैं। Minitab भी यही दायरे AIAG की गाइडलाइन बताकर देता है।
10–30% अपने आप पास नहीं है। इस दायरे में इस्तेमाल और लागत देखकर फ़ैसला होता है।
स्रोत: Minitab Help और QI Macros, जो इन्हें AIAG की गाइडलाइन बताकर देते हैं। शर्तें कस्टमर और इंडस्ट्री के हिसाब से अलग होती हैं।
उदाहरण का %GRR 19.9% बीच वाले "शर्त के साथ ठीक" दायरे में आता है। ndc 6 है, जो शर्त पूरी करता है: सिस्टम प्रोसेस के variation को लगभग छह समूहों में बाँट सकता है।
ndc 5 से कम हो तो हो सकता है कि नापने का सिस्टम मोटा हो, या चुने हुए पार्टों में variation बहुत कम हो। ndc के ऊपर वाले हिस्से में part variation (PV) है, इसलिए ग़लत चुने पार्टों से ndc कम आ सकता है, चाहे नापने के सिस्टम में कोई कमी न हो।
किससे भाग दें: प्रोसेस variation या टॉलरेंस?
%GRR को total (प्रोसेस) variation के मुक़ाबले भी निकाला जा सकता है और टॉलरेंस के मुक़ाबले भी। टॉलरेंस से अनुपात में 6 × GRR (±3 standard deviation की चौड़ाई) को टॉलरेंस की चौड़ाई से भाग देते हैं। इसे P/T ratio (precision-to-tolerance ratio) भी कहते हैं।
Minitab के हिसाब से total variation से अनुपात पूरे प्रोसेस के variation से तुलना है, और टॉलरेंस से अनुपात पार्टों को स्पेक के अंदर और बाहर छाँटने के काम का पैमाना है। इसी से आम चलन निकलता है: जो नाप कंट्रोल चार्ट में जाते हैं उनके लिए total variation से अनुपात, और जो फ़ाइनल inspection में pass/fail के लिए हैं उनके लिए टॉलरेंस से अनुपात। कौन-सा लेना है, यह नाप के इस्तेमाल और कस्टमर की माँग से तय होता है, और कुछ रिपोर्टों में दोनों दिखाते हैं।
भाग देने वाली चीज़ बदलने से उसी डेटा का नतीजा बदल जाता है। उदाहरण में total variation के मुक़ाबले %GRR 19.9% है, पर 0.10 mm टॉलरेंस के मुक़ाबले 25.5%। रिपोर्ट में हमेशा लिखें कि अनुपात किसके मुक़ाबले है, ताकि आपके नंबर कस्टमर के नंबरों से न टकराएँ। जापानी ड्रॉइंग की general tolerance के लिए देखें: ।
10% और 30% के अलावा जापानी कस्टमर क्या चाह सकते हैं
10% और 30% AIAG की गाइडलाइन हैं, हर जगह की हद नहीं। IATF 16949 में MSA reference manual डिफ़ॉल्ट है, पर कस्टमर मंज़ूर करे तो दूसरा विश्लेषण तरीका और शर्तें भी चल जाती हैं। इसलिए कार कंपनियाँ और Tier 1 अपने customer-specific requirements (CSR; जापानी में kokyaku koyu yokyu jiko) में अपनी शर्तें या दायरा तय कर सकती हैं।
जापानी गाइडबुक और कंपनियों के अंदरूनी स्टैंडर्ड में कभी-कभी शर्त वाले दायरे को और बाँट दिया जाता है, जैसे 10–20% को आम तौर पर ठीक और 20–30% को आख़िरी हद मानना। हर कंपनी की माँग अलग होती है, इसलिए एक जापानी कस्टमर का नियम दूसरे पर लागू न मानें। सुरक्षित क्रम यह है कि पहले कस्टमर की माँग पक्की करें, फिर अपना अंदरूनी स्टैंडर्ड उससे ढीला न रखें।
SPC for Excel के मुताबिक AIAG मैन्युअल खुद चेतावनी देता है कि सिर्फ़ GRR की गाइडलाइन को पास-फ़ेल की हद बना लेना नापने के सिस्टम को परखने का ठीक तरीका नहीं है। इसलिए सिर्फ़ यह न देखें कि नंबर हद के अंदर है, यह भी देखें कि वह नाप किस फ़ैसले के लिए इस्तेमाल हो रहा है।
रिज़ल्ट ख़राब आए तो क्या करें
%GRR ज़्यादा आए तो सबसे पहले देखें कि repeatability (EV) बड़ी है या reproducibility (AV)। AIAG MSA 4th edition पर आधारित गाइड, जैसे QI Macros, संभावित कारण नीचे की तरह छाँटते हैं।
कहाँ सुधार करना है, यह इस पर निर्भर है कि EV बड़ा है या AV, और ndc काफ़ी है या नहीं।
स्रोत: QI Macros (AIAG MSA 4th edition पर आधारित गाइड) और Minitab technical paper। कोई भी सुधार करने के बाद वही शर्तें रखकर स्टडी दोबारा करें और असर देखें।
उदाहरण में %AV (14.7%) %EV (13.3%) से थोड़ा बड़ा है, और नापने वाले C का औसत B से लगभग 6 µm कम है। यहाँ यह देखकर शुरू करें कि C माइक्रोमीटर कैसे लगाता है (ratchet इस्तेमाल करता है या नहीं, और नापने की फ़ेस पार्ट पर सीधी बैठती हैं या नहीं), और स्केल कैसे पढ़ता है।
Repeatability की दिक़्क़त हो तो नया गेज ख़रीदने से पहले fixture और तय नापने की जगह आज़माएँ। अक्सर कारण गेज की क्षमता से ज़्यादा यह होता है कि पार्ट कैसे रखा गया या कहाँ नापा गया। कारण ढूँढने के लिए नापने वाले और पार्ट के हिसाब से रीडिंग का ग्राफ़ बनाएँ, या cause-and-effect (fishbone) डायग्राम में आदमी, गेज, तरीका और माहौल के नीचे कारण लिखें।
आम गलतियाँ जिनसे स्टडी दोबारा करनी पड़ती है
- 10 पार्ट एक ही लॉट से लिए, इसलिए part variation कम रहा और %GRR ख़राब दिखा
- नापते समय पार्ट के नंबर दिख रहे थे, इसलिए नापने वालों ने पिछली रीडिंग से मिलाकर लिखा
- सिर्फ़ सबसे अच्छे नापने वाले ने हिस्सा लिया, इसलिए रोज़ के नाप से बेहतर रिज़ल्ट आया
- नापने की जगह तय नहीं थी, इसलिए पार्ट के अंदर का variation repeatability में घुस गया
- 5.15-sigma factor वाला पुराना template इस्तेमाल किया, इसलिए EV और AV कस्टमर के हिसाब से नहीं मिले
- %GRR बिना बताए रिपोर्ट किया कि किससे भाग दिया (total variation या टॉलरेंस), इसलिए कस्टमर के नंबर से टकराया
जब कस्टमर नाप की किसी गड़बड़ी की तरफ़ इशारा करके corrective action रिपोर्ट माँगता है, तब MSA के नतीजे root-cause विश्लेषण का सबूत बन सकते हैं। यह दिखाना कि नापने का सिस्टम जाँचा गया है और %GRR कितना है, उपाय को ज़्यादा भरोसेमंद बनाता है। उस फ़ॉर्मेट के लिए देखें: ।
गिनती वाला नहीं, पास/फ़ेल वाला MSA: Attribute MSA और Kappa
ऊपर के हिसाब उन नापों पर नहीं चलते जिनका नतीजा सिर्फ़ पास या फ़ेल होता है: विज़ुअल inspection, limit sample (gendo mihon) से मिलान, या go/no-go गेज। ऐसे attribute measurement system को इस पर जाँचते हैं कि फ़ैसले आपस में कितने मिलते हैं।
आम तरीका AIAG मैन्युअल का cross-tab तरीका है। ऐसे पार्ट लें जिनका सही फ़ैसला (reference) पहले से पता हो। कई नापने वाले हर पार्ट पर कई बार फ़ैसला देते हैं, और नापने वालों के आपस में और reference से मेल को kappa में लिखा जाता है। Kappa संयोग से हुए मेल को हटाकर मेल का स्तर बताता है: 1 का मतलब पूरा मेल और 0 का मतलब संयोग से बेहतर नहीं। Minitab के मुताबिक AIAG kappa 0.75 या उससे ऊपर को अच्छा मेल मानता है, और 0.90 जैसी बड़ी वैल्यू बेहतर है।
नतीजे तीन तरह से पढ़ें: हर नापने वाले के अंदर (क्या वही आदमी दोबारा वही फ़ैसला देता है?), हर नापने वाले और reference के बीच (क्या फ़ैसले सही हैं?), और नापने वालों के बीच (क्या आदमी बदलने से फ़ैसला बदलता है?)। SPC for Excel ने AIAG मैन्युअल (3rd edition) की एक टेबल का हवाला दिया है, जिसमें reference से तुलना के लिए ये गाइडलाइन हैं: effectiveness 90% या ज़्यादा, miss rate (ख़राब पार्ट को पास कर देना) 2% या कम, और false alarm rate (अच्छे पार्ट को रिजेक्ट कर देना) 5% या कम।
कस्टमर ने शर्तें दी हों तो वही मानें। पार्टों में सिर्फ़ साफ़ अच्छे और साफ़ ख़राब न रखें, सीमा के पास वाले भी रखें। सीमा वाले पार्ट न हों तो फ़ैसलों का फ़र्क कभी दिखता ही नहीं।
रिपोर्ट भेजने से पहले: चेकलिस्ट और जापानी कस्टमर से सवाल
ऊपर की कई गलतियाँ, जैसे बिना बताए भाग देने वाली चीज़ या पुराने factor, ख़राब गेज से नहीं बल्कि आपस की मान्यताओं के न मिलने से आती हैं। इन बातों को स्टडी से पहले कस्टमर से तय कर लें, रिपोर्ट लौटने के बाद नहीं।
भेजने से पहले का चेकलिस्ट
| बात | क्या पक्का करना है |
|---|---|
| दायरा (Scope) | Characteristic, गेज, fixture और तरीका तय हैं; characteristic कंट्रोल प्लान में है |
| रिज़ॉल्यूशन | Least count टॉलरेंस (या प्रोसेस variation) का 1/10 या उससे बारीक है |
| कैलिब्रेशन | गेज की कैलिब्रेशन चालू है |
| स्टडी का डिज़ाइन | पार्ट, नापने वालों और trial की गिनती लिखी है; पार्ट प्रोसेस की पूरी रेंज से हैं; क्रम random है; पार्ट के नंबर छुपे हैं |
| नापने वाले | जो लोग रोज़ यह नाप करते हैं, सिर्फ़ सबसे अच्छा इंस्पेक्टर नहीं |
| तरीका | Average and range या ANOVA लिखा है; ANOVA में interaction रखी गई या हटाई, यह लिखा है |
| Factor | K1, K2, K3 4th edition के हैं (पुराने 5.15-sigma वाले नहीं) |
| किससे भाग दिया | %GRR total variation, टॉलरेंस या दोनों के मुक़ाबले, साफ़ लिखा है |
| नतीजे | %EV, %AV, %GRR, ndc; range को कंट्रोल लिमिट से मिलाया गया है |
| शर्तें | रिपोर्ट में लिखा है कि कौन-सी शर्तें लगाईं (AIAG या कस्टमर का CSR) |
| शर्त वाला दायरा | %GRR 10–30% हो तो यह लिखा है कि इस इस्तेमाल के लिए वह क्यों ठीक है, और ज़रूरत हो तो कस्टमर की मंज़ूरी है |
| Attribute जाँच | सीमा वाले पार्ट शामिल हैं; kappa, effectiveness, miss rate और false alarm rate लिखे हैं |
जापानी कस्टमर से पूछने वाले सवाल
- किन characteristic पर MSA चाहिए: कंट्रोल प्लान की हर चीज़ पर, या सिर्फ़ special और critical characteristic पर?
- क्या आप AIAG MSA 4th edition की शर्तें मानते हैं, या CSR में आपकी अपनी शर्तें हैं (जैसे 10–30% के दायरे के अंदर बँटवारा)?
- %GRR प्रोसेस variation के मुक़ाबले निकालें, टॉलरेंस के मुक़ाबले, या दोनों के?
- क्या आप तरीका (average and range या ANOVA) और पार्ट, नापने वालों व trial की गिनती तय करते हैं?
- क्या आपका अपना Excel फ़ॉर्मेट चाहिए, और वह किस edition के factor इस्तेमाल करता है?
- विज़ुअल inspection के लिए क्या आप limit sample (gendo mihon) देंगे, और kappa या effectiveness कितनी चाहिए?
- स्टडी दोबारा कब करनी है: गेज बदलने पर, तरीका बदलने पर, नापने वाले बदलने पर, या तय अंतराल पर?
पूछताछ का नमूना ईमेल (English में, कस्टमर को भेजने के लिए)
Subject: Gage R&R requirements for part [part number]
Dear [Name],
We are preparing the measurement system analysis for [part number / drawing number] as listed in our control plan. To make sure our report matches your requirements, could you confirm the following?
1. Acceptance criteria: AIAG MSA 4th edition (%GRR under 10% / 10–30% / over 30%, ndc of 5 or more), or your own criteria?
2. Denominator for %GRR: process variation, tolerance, or both?
3. Preferred method (average and range or ANOVA) and study size (parts, appraisers, trials)
4. Whether a specific report format is requiredIf any characteristic falls in the 10–30% range, we will assess whether it is acceptable for its intended use and confirm with you.
Best regards,
[Your name]
इस गाइड की सीमाएँ
- हल किया उदाहरण काल्पनिक डेटा का है। असली स्टडी में अपने कस्टमर का फ़ॉर्म और software की सेटिंग मानें।
- शर्तें कस्टमर, इंडस्ट्री और characteristic के हिसाब से अलग होती हैं। यहाँ के AIAG दायरे एक संदर्भ हैं, कस्टमर के CSR की जगह नहीं।
- यह गाइड आम crossed स्टडी बताती है, जिसमें हर नापने वाला हर पार्ट नापता है।
- IATF 16949 के सही शब्दों के लिए स्टैंडर्ड खुद और AIAG का मौजूदा मैन्युअल देखें, सिर्फ़ दूसरे स्रोत नहीं।
- IS 15393 की बात सिर्फ़ शब्दों की परिभाषा के लिए है। Gage R&R का तरीका और 10%/30% की गाइडलाइन AIAG की हैं, BIS की नहीं।
अक्सर पूछे जाने वाले सवाल (FAQ)
Gage R&R स्टडी कितने समय बाद दोबारा करनी चाहिए?
कोई तय अंतराल नहीं है। गेज बदलने, तरीका बदलने या नापने वाले बदलने पर इसे फिर देखें। कस्टमर के CSR में शर्तें या दायरा तय हो तो उसी के हिसाब से प्लान करें।
गेज कैलिब्रेटेड है, तो भी क्या Gage R&R चाहिए?
हाँ। कैलिब्रेशन सिर्फ़ इंस्ट्रूमेंट का bias जाँचता है। Fixture के ढीलेपन या नापने वालों की आदतों से आने वाला variation उसमें नहीं आता, और वही Gage R&R जाँचता है।
Gage R&R का पूरा नाम क्या है?
Gage Repeatability and Reproducibility। Repeatability को EV, reproducibility को AV और दोनों मिले हुए को GRR लिखते हैं। जापानी कागज़ों में भी यही छोटा नाम चलता है।
क्या Gage R&R spreadsheet में निकाला जा सकता है?
Average and range तरीका spreadsheet में आसानी से हो जाता है: factor से गुणा करें और मिलाएँ। ANOVA में हिसाब ज़्यादा है, इसलिए statistical software या spreadsheet के analysis टूल से मेहनत बचती है।
नापने वाले कौन होने चाहिए?
दो या तीन ऐसे लोग जो यह नाप रोज़ करते हैं, सिर्फ़ सबसे हुनरमंद आदमी नहीं। सिर्फ़ सबसे अच्छे इंस्पेक्टर से कराने पर रिज़ल्ट रोज़ के नाप से बेहतर आता है और variation कम दिखता है।
स्रोत (Sources)
- AIAG, MSA-4: Measurement Systems Analysis
- Q-DAS, Notes on the 4th Edition of the MSA Manual (छपने की तारीख़ और 5.15 factor)
- JIS Z 8103:2019 (नापतोल के शब्द) और JIS Z 8402-1:1999 (जापानी): Z 8103, Z 8402-1
- BIS, IS 15393-1 (2003): Accuracy (Trueness and Precision) of Measurement Methods and Results, Part 1 (ISO 5725-1:1994 के बराबर अपनाया गया)
- Minitab, Is my measurement system acceptable?
- Minitab, Interpret the key results for Crossed Gage R&R Study
- Minitab, Methods and formulas for gage R&R table और Methods and formulas for method of analysis
- Minitab, Data considerations for Crossed Gage R&R Study और Assistant technical paper: Gage R&R Study (Crossed)
- Minitab, What is gage resolution?
- SPC for Excel, Variable Measurement Systems – Part 4: Gage R&R
- SPC for Excel, Acceptance Criteria for Measurement Systems Analysis
- SPC for Excel, Attribute Gage R&R Studies – Part 2
- QI Macros, Gage R&R Made Easy
- IATF 16949 clause 7.1.5.1.1 का सार (जापानी): IATF16949 koryaku
मूल जापानी लेखयह गाइड जापान के पाठकों के लिए लिखे गए MONOSCOPE के एक लेख पर आधारित है: ゲージR&Rのやり方|MSAの手順・計算例と判定基準10%・30%の読み方
संपादक के बारे में
 MONOSCOPE संपादकीय टीमFOUNDER & EDITOR
प्लांट उपकरण निर्माता और प्लांट इंजीनियरिंग कंपनी में लगभग दस साल तक उपकरणों के प्रस्ताव, डिज़ाइन और कमीशनिंग का काम करने के बाद डिजिटल मार्केटिंग में आए। आज B2B निर्माताओं को वेब कंसल्टिंग देते हैं, ताकि वे अपने उत्पाद और तकनीक आसानी से समझा सकें। जापान के राष्ट्रीय लाइसेंस Energy Manager और तृतीय श्रेणी चीफ़ इलेक्ट्रिकल इंजीनियर धारक।
2017 से एक इंजीनियरिंग ब्लॉग (500 से ज़्यादा लेख) और लगभग 20,000 सब्सक्राइबर वाला जापानी YouTube चैनल चलाते हैं। हर गाइड जापानी शॉप फ़्लोर के नज़रिए से लिखा जाता है और उद्धृत मानकों से मिलाकर जाँचा जाता है।


