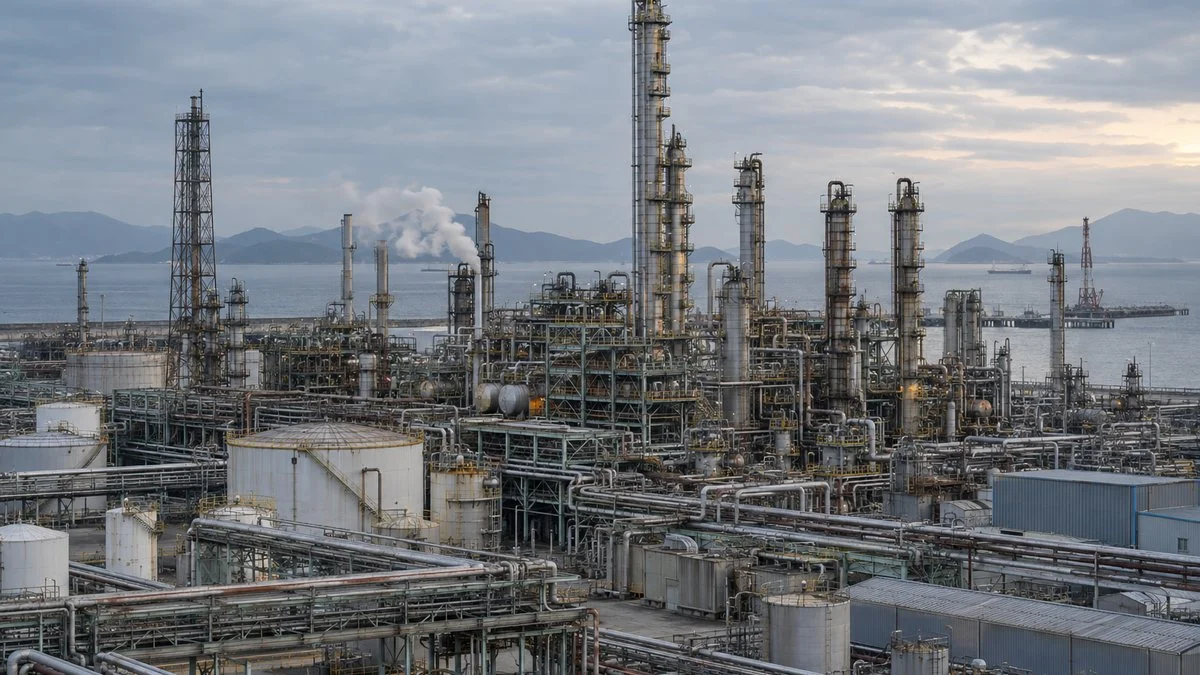
プラント(化学製品や石油製品をつくる大型の生産設備)では、設備の故障や運転異常の「前ぶれ」をデータから早めに見つけ、止まる前に手を打つ仕組みが使われています。
これが故障予兆監視で、軸受(回転する軸を支える部品)の振動がじわじわ増える、といった変化を捉えます。
監視には、性質の違うデータを組み合わせます。DCS(温度や圧力などを制御・監視する中核のシステム)に集まるデータ、ポンプや圧縮機の振動、配管や塔・タンクの壁の厚さといったものです。
兆しを見つけたあと、誰がどう対応するかまで決めて、ようやく役に立つ仕組みになります。
この記事では、プラントの故障予兆監視とは何かを、監視する対象の分類、データの流れ、代表的な手法、国内の事例、導入の進め方、つまずきやすい点という順で整理します。
プラントの故障予兆監視とは
プラントの故障予兆監視とは、設備の故障や運転異常の「前ぶれ」をデータから早めに見つけ、止まる前に手を打つための仕組みです。
ここでいう前ぶれは、軸受の振動がじわじわ増える、同じ運転条件なのに熱交換器の出口温度が少しずつずれていく、といった変化を指します。
化学・石油プラントは、DCS(分散制御システム。温度・圧力・流量などを制御し、運転員が監視する中核のシステム)で運転されています。
DCSにも警報はありますが、多くは設定した上限を超えた、下限を下回ったというときに鳴る仕組みです。警報が鳴った時点では、すでに異常が表に出ていることが少なくありません。
予兆監視はその手前をねらいます。一つひとつの値は正常範囲に収まっていても、値どうしの関係がいつもと違う状態を捉えることで、警報より早く気づく余地が生まれます。
考え方の土台は一般的な予知保全の仕組みと同じです。ただしプラントでは、設備を1台ずつ見るだけでなく、配管でつながったプロセス全体の中で異常の兆しを探す点に特徴があります。
3つは置き換えではなく、見ている時間軸と得意な異常が異なります。
※実際のプラントでは3つを組み合わせて使います。予兆監視はDCSの警報や法定の検査を置き換えるものではありません。
化学・石油プラントで予兆監視が求められる理由
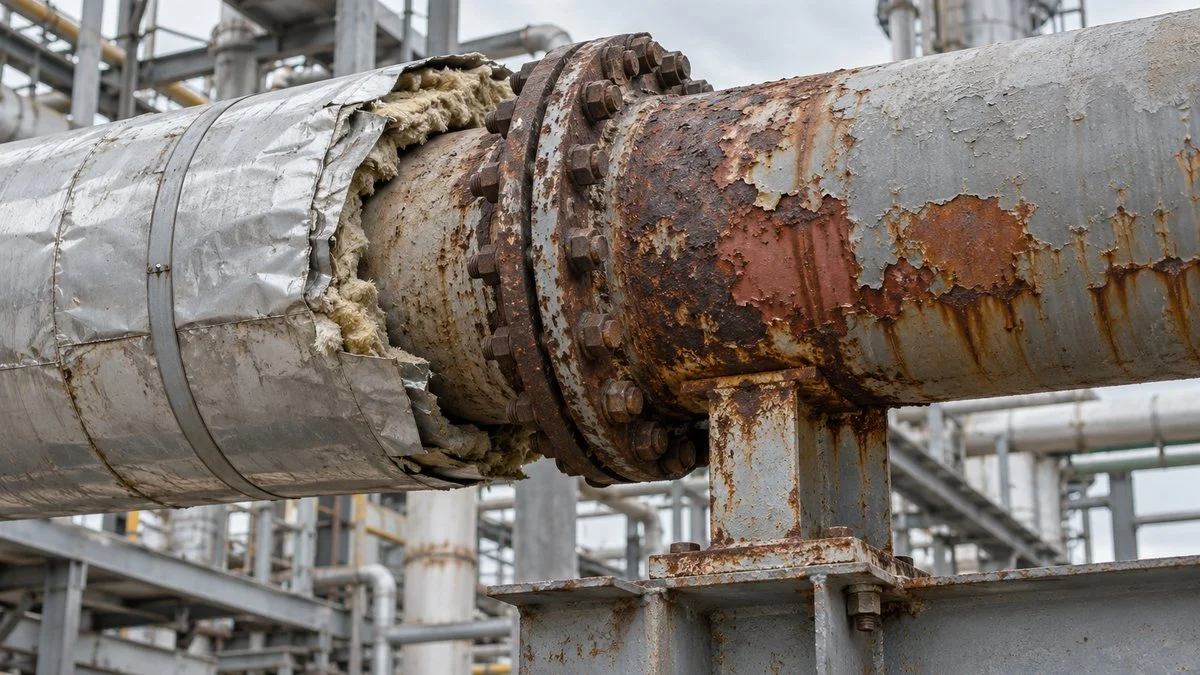
化学・石油プラントは、原料を入れ続けて製品を取り出す連続プロセスです。1台のポンプが止まっただけで、装置全体の運転を落とさなければならない場面もあります。
日立製作所の技術誌「日立評論」では、高度経済成長期に建設された国内の石油・化学プラントの状況が紹介されています。経年劣化による突発故障が起き、大事故に至らなくても数億〜数十億円規模の損失が発生しているといいます。
止まってから直すより、止まる前に手を打つほうが得になりやすい構造です。
人の面の課題もあります。
経済産業省はプラント保安の構造的な課題として、設備の高経年化、人材の高齢化・不足、技術・技能伝承力の低下を挙げています。そのうえで、これまでのように人手をかけた保安体制では立ち行かないとしています。
熟練の運転員が「この温度の上がり方は怪しい」と感じ取っていた判断を、データで補う必要が出てきたわけです。
事故の原因にも傾向があります。神奈川県がまとめた資料によると、県内の石油コンビナート地域の特定製造事業所で2024年に起きた高圧ガス事故等は53件でした。
原因別では腐食管理不良が20件と最も多くなっています。同じ資料では、石油コンビナート地域の異常現象でも、配管系の漏洩の主な原因は外面腐食などの設備の劣化とされています。
回転機だけでなく、配管や塔槽のような動かない設備の劣化も監視の対象になるのは、こうした実態があるためです。
国もデータの活用を後押ししています。
高圧ガス保安法の認定事業者制度では、CBM(状態基準保全)の考え方を取り入れることで、開放検査の周期を12年超とすることが認められました。CBMは、データを使って腐食などの要因となる環境の変化を把握する考え方です。
対象は高い保安力を持つ特定認定事業者(スーパー認定事業者)に限られ、損傷の種類も減肉に限定されています。
AIについては、2020年11月に経済産業省が「プラント保安分野AI信頼性評価ガイドライン」と「プラントにおける先進的AI事例集」を策定しました。AIの信頼性をどう評価し、社内外に説明するかの考え方が示されています。
設備・人・事故・制度の4つの面から、データで見張る必要性が高まっています。
※事故件数は神奈川県の石油コンビナート地域(コンビ則適用事業所)の2024年の集計です。
時間基準で決まった周期に点検・交換する方法と、状態を見て時期を決める方法の違いは、次の記事で整理しています。
監視する対象は3つ|プロセス・回転機・静機器
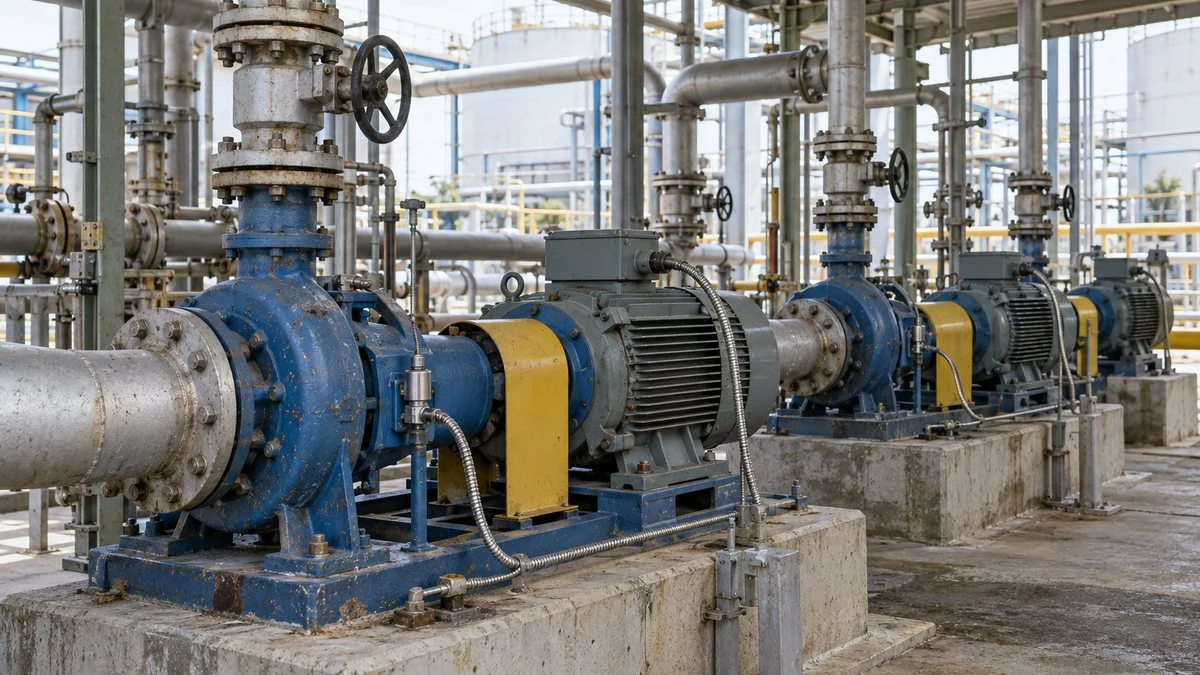
プラントの予兆監視で見る対象は、「プロセス」「回転機」「静機器」の3つに分けると整理しやすくなります。
化学プラントには塔槽類や反応槽のような動かない静機器と、ポンプや送風機のような回転機があり、劣化の仕方も、適した診断技術もそれぞれ異なります。そこに、運転そのものの異常であるプロセスが加わります。
対象によって、使うデータと見つけたい兆候が変わります。
プロセスの異常
プロセスの異常は、設備が壊れる前に「運転のしにくさ」として現れることがあります。配管や塔の内部に生成物が付着して流れが悪くなる閉塞や、熱交換器の伝熱面が汚れて能力が落ちるファウリングが代表例です。
これらは1つの計測値だけでは判断がつきにくい現象です。流量に対して圧力損失が増えている、同じ加熱量なのに出口温度が上がらないといった、値どうしの関係で気づくことになります。
そのためプロセスの予兆監視では、複数の変数をまとめて扱う手法が使われます。
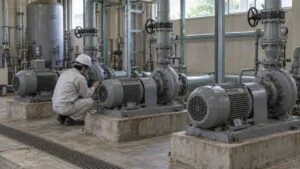
回転機(ポンプ・圧縮機・送風機)
回転機は可動部を持つため、軸受の摩耗や損傷、回転体のアンバランスといった劣化が起こります。診断は振動が中心で、軸受ごとに垂直・水平・軸方向の3方向で測るのが基本です。
現場の担当者が携帯型の測定器で振動の傾向を見る簡易診断で異常をふるい分け、疑わしいものを専門家が周波数解析で詳しく調べる、という二段構えがよく採られます。重要な機器には固定センサーを付けて常時監視する方式も使われています。
このとき、振動の値そのものより、判定基準をどこに置くかが診断の精度を左右します。測定点の決め方や異常パターンの見分け方は、次の記事で詳しく整理しています。
静機器(塔槽・熱交換器・配管)
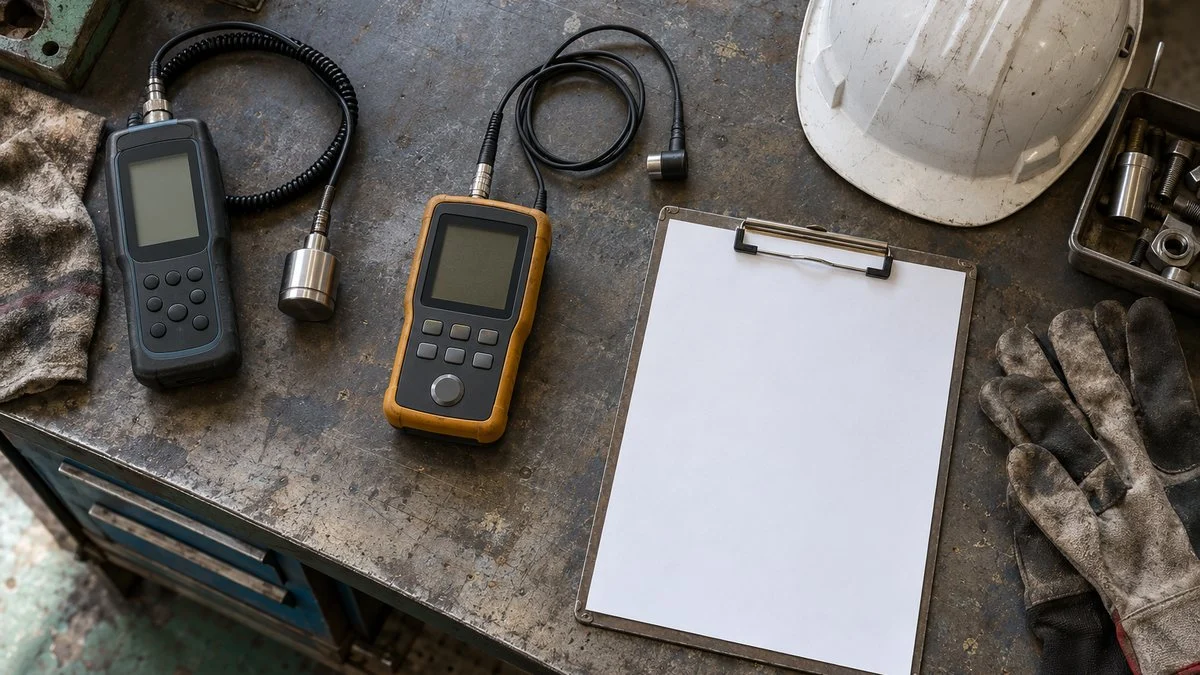
塔槽、熱交換器、配管、タンクといった静機器は、動かない代わりに内部の流体や外気の影響で少しずつ減肉・腐食していきます。従来は、運転を止める定期修理(定修)のときに開放して肉厚などを測るのが基本でした。
近年は、運転しながら状態を測る技術の導入が進んでいます。
消防庁の検討会は、石油・化学などの12事業所を調べた資料をまとめています。導入済みまたは導入を検討中のものとして、9事業所から55種類(重複を含む)のモニタリング・診断技術が挙げられました。
配管の連続肉厚測定、超音波によるリアルタイムの腐食モニタリング、保温配管を広い範囲で調べるガイド波、加熱炉や保温配管の赤外線サーモグラフィーなどです。
静機器の劣化は長い時間をかけて進むため、その場で警報を出すより、減肉の速さから余寿命を見積もって補修の時期を決める使い方が中心になります。
予兆監視を支えるデータの流れ|DCSからヒストリアンまで
予兆監視は、分析のモデルだけでは成り立ちません。現場のセンサーでデータを取り、ためて、分析し、人が判断して処置し、その結果を次の判断に生かすという流れ全体が1つの仕組みです。
センサーから運転員・保全担当の処置までがつながって、初めて監視が機能します。
※構成は一例です。DCSとヒストリアンの間に別の収集サーバーを置くなど、プラントごとに異なります。
DCSとヒストリアンの役割分担
DCSは、プラントをリアルタイムで制御し、運転員が監視するためのシステムです。
一方で、何年分ものデータをさかのぼって分析するには、プラントヒストリアン(プラント情報管理システム、PIMSとも呼ばれる)にデータをためておくのが一般的です。
代表的な製品であるPIシステムは、プラントのデータを数年にわたってオンラインで保存できることを特徴にしています。
予兆監視のモデルは過去の正常な運転データから学ぶため、何年分のデータが、どのくらいの間隔で残っているかが導入の成否を分けます。
保存の間隔が粗い、圧縮の設定で細かな変化が残っていないといった理由で、手元のデータがそのままでは使えないこともあります。
センサーそのものの原理や方式の違いは、センサー・計測の基本原理で整理しています。
DCSに入らないデータも組み合わせる
DCSに入ってこないデータも重要です。巡回点検の記録、携帯型測定器で測った振動値、定修時の肉厚測定結果、過去のトラブル報告などは、紙や表計算ファイルに分かれて保管されていることが少なくありません。
これらを検知結果と結びつけておくと、「前回この兆候が出たときは何が原因で、どう処置したか」をすぐに引き出せます。検知の精度だけでなく、検知したあとに動きやすくなる点が、データをまとめる効果です。
主な手法|しきい値からMT法、AI異常検知まで
予兆を見つける手法は、単純なものから順に「しきい値とトレンド管理」「MT法」「回帰モデル」「相関・クラスタリング型のAI」と並べると違いがつかみやすくなります。どれが優れているかではなく、対象と目的によって使い分けるものです。
見るデータの数が増えるほど、手法も「1つの値」から「値どうしの関係」へ移ります。
※実際の製品は複数の手法を組み合わせていることが多く、名称も各社で異なります。
しきい値とトレンド管理
最も基本的なのは、振動値や軸受温度などに注意値・危険値を決め、値の大きさと増え方の傾きを追う方法です。仕組みが単純で、なぜ通知が出たのかを誰でも説明できる利点があります。
弱点は、見るべき値を人があらかじめ決めておく必要があることです。季節や負荷で値が動く設備では、固定のしきい値だと誤報と見逃しの両方が増えやすくなります。ばらつきや傾向の読み方は、製造業のデータ分析の基本で身につけておくと判断が安定します。
MT法
MT法(マハラノビス・タグチ法)は、品質工学で生まれた異常検知の手法です。まず正常とみなせるデータの集まり(単位空間)をつくり、今のデータがそこからどれだけ離れているかを、変数どうしの相関を考慮したマハラノビス距離で測ります。
振動、内部温度、油圧のように複数の信号をまとめて1つの指標にできるのが強みです。さらにSN比と呼ぶ指標を見ることで、どの信号が異常に効いているかという要因の絞り込みもできます。信号の数が多い場合は、グループに分けて計算する方法も使われます。
一方で、単位空間に何を入れるかで結果が大きく変わります。運転条件の違うデータを混ぜると、正常の範囲が広がりすぎて異常を見逃す原因になります。
回帰モデル(推定値と実測値のずれを見る)
回帰モデルは、ある変数の「本来あるべき値」を周辺の変数から推定し、実測値とのずれで異常を捉える方法です。
アズビルの技術論文では、異常が起きたときに最初に影響が出る変数を目的変数とする手法が紹介されています。流量や弁開度など、関係する周辺の変数との関係をニューラルネットワークで学習させます。
現場の知見を使って変数の組み合わせを決めるため精度は高い反面、捉えられるのは局所的な関係です。大規模なプラントでは多数のモデルを作る必要があり、多大な工数がかかることや、未知の異常では目的変数を決めにくいことが課題として挙げられています。
相関・クラスタリング型のAI
変数の数が多いプラント全体を網羅的に見張るために使われるのが、多数の変数どうしの関係をまとめて学習し、その崩れを探すタイプのAIです。
同じ論文では、変数間の相関の構造と運転状態の分類を同時に推定する手法を、火力発電プラントの重原油ポンプの軸受損傷の実データで検証しています。
運転員がDCSの警報で気づいた時刻に対し、約4時間前に変調を検知できたという報告です。
日立製作所が紹介しているのは、正常時のモデルからの乖離とセンサー間の相関を組み合わせて、異常の原因となっているセンサーを絞り込む技術です。実際の故障日の約10日前に異常を検出した例も示されています。
この種の手法で実務上重要なのは、「異常らしい」と知らせるだけでなく、どの変数、どの機器がおかしいのかを示せるかどうかです。候補が示されなければ、運転員は結局すべてのトレンドを見直すことになります。
国内の取り組み事例
国内の化学・石油各社では、試験導入の段階を越えて、実際の運転で予兆監視を使う例が出てきています。公表されている代表的な取り組みを整理します。
実運用の例と、技術検証の例を分けて見ると、進み具合がつかめます。
※各社の公表資料にもとづく。効果の数値は個別の事例・条件でのものです。
ENEOS:製油所の数万個のセンサーをAIで見張る
ENEOSは、米アスペンテックの産業用AIによる異常予兆検知システム「Aspen Mtell」を製油所で使っています。
2019年に仙台製油所で実証を始めて効果を確かめ、2025年3月には製油所・製造所の各拠点に展開していくと発表しました。
製油所には温度や圧力、振動などを測る数万個のセンサーがあり、そのデータ同士の相関から、人間には判別できない異常の種を見つけることをねらっています。
レゾナック:検知と「次に何をするか」をセットにする
レゾナックは大分コンビナートのエチレンプラントで、日立製作所の異常予兆検知システムとデータ管理基盤を採用し、2024年5月に本格運用を始めました。
エチレン製造の運転業務に関する約3,000のアラーム(異常予兆などの警告)を対象に、業務ノウハウをデジタル化しました。過去のトラブル情報や運転手順、マニュアルなど、異常の解決に必要な情報を運転員に示す仕組みです。
この事例で注目したいのは、検知の精度よりも、検知したあとの行動を支える部分に力を入れている点です。運転員が同じ情報を得るまでの時間は、従来の約半分に短縮されたとしています。
運転支援AIとの組み合わせも進む
予兆監視と並んで、AIで運転操作そのものを支援する取り組みも進んでいます。
三井化学、NEC、産業技術総合研究所、オメガシミュレーションは2020年、運転支援システムの成果を発表しました。
AIとプラントの動きを再現するシミュレーターを組み合わせたもので、生産量を変える運転変更操作の時間を運転員の手動操作に比べて40%短縮できたといいます。
異常の兆しに気づく仕組みと、気づいたあとに運転をどう調整するかを支える仕組みは、今後つながっていく方向にあります。
故障予兆監視の導入の進め方|5つのステップ
予兆監視は、最初からプラント全体に広げようとするとうまくいきません。対象を絞って小さく始め、運用のルールを固めてから広げるのが基本です。
準備、構築と検証、運用の3段階で進めます。
※ステップ3と4は、判定基準が安定するまで何度か往復するのが一般的です。
ステップ1:対象を絞る
最初に決めるのは、どの設備の、どんな故障を防ぎたいかです。予備機がなく、止まると装置全体の減産につながる圧縮機やポンプ、過去にトラブルを繰り返している熱交換器などが候補になります。
このとき、設備ごとに起こりうる故障モードと、その影響の大きさを先に整理しておくことが、監視すべき変数を決める近道です。故障モードの洗い出しには、FMEAのやり方が参考になります。
ステップ2:データを棚卸しする
対象が決まったら、必要なデータがそろっているかを確かめます。DCSのタグ(計測点)がヒストリアンに何年分、どの間隔で残っているか、振動や肉厚の測定記録がどこにあるか、過去の故障がいつ起きたかの記録があるかを一覧にします。
故障の記録は、モデルの評価に欠かせません。過去の故障の前に、データにどんな変化が出ていたかを確かめられれば、その手法で本当に早く気づけるかを導入前に検証できます。
ステップ3:正常を定義してモデルをつくる
予兆監視の多くは、正常な状態を学んで、そこからのずれを見る方式です。そのため「どの期間を正常とみなすか」の決め方が結果を左右します。
化学プラントでは、スタートアップやシャットダウン、製品銘柄の切り替え、定修の前後で、値どうしの関係が大きく変わります。
運転モードを分けずに学習させると、正常の範囲が広がりすぎて異常を見逃しやすくなります。運転員や生産技術の担当者と一緒に、期間を選ぶのが確実です。
ステップ4:試行運用で判定基準を詰める
モデルができたら、すぐに本運用にせず、一定期間は通知を記録するだけにして運転員の判断と並べて比べます。通知が出たときに実際に異常があったか、異常があったのに通知が出なかったかを記録し、しきい値や対象の変数を調整します。
この期間で、運転員が「この通知は見る価値がある」と納得できる水準まで誤報を減らせるかが、その後の定着を決めます。
ステップ5:対処手順とセットで本運用へ
本運用に入る前に、通知が出たら誰が確認し、どの順で何を調べ、どの段階で保全部門に依頼するかを決めておきます。予兆監視を設備保全の仕事の流れの中に組み込み、点検計画や補修計画とつなげることで、見つけた兆しが実際の処置に結びつきます。
AIを使う場合は、モデルがどんなデータで学習し、どの程度の精度で、どんな条件で使えないのかを記録しておくことも大切です。
経済産業省のAI信頼性評価ガイドラインも、AIの信頼性を社内外に説明できる状態にしておくことを重視しています。対象設備で成果が確認できたら、同じ種類の設備や別の装置へ広げていきます。
導入でつまずきやすい点
故障予兆監視は、技術よりも運用の面でつまずくことが多い仕組みです。よくある失敗と、その対策を整理します。
誤報が多く、通知が見られなくなる
最も多いのが、誤報が続いて運転員が通知を見なくなるケースです。運転モードの切り替えや計器の校正、センサーの一時的な不調でも「いつもと違う」と判定されるため、試行運用の段階で除外の条件を決めておく必要があります。
通知の数を絞るときは、重要度の低い通知を運転員ではなく保全やデータ分析の担当者に回すなど、受け取る人を分ける方法も有効です。
「正常」のデータに異常が混ざっている
学習に使った期間に、実はすでに劣化が始まっていたというケースもあります。その場合、劣化した状態を正常として覚えてしまい、同じ兆候が出ても検知できません。
学習期間を選ぶときは、保全記録と照らし合わせ、補修や部品交換の直後など、状態が確かな期間を選ぶのが安全です。
見つけた後の担当が決まっていない
予兆を検知しても、確認するのが運転部門か保全部門か決まっていないと、通知は誰にも拾われずに流れていきます。システムの導入をDX推進や計装の担当者だけで進めた場合に起きやすい問題です。
導入の初期から運転と保全の担当者を巻き込み、通知ごとに一次確認の担当と対応の期限を決めておくと、仕組みが業務として回りはじめます。
モデルを作りっぱなしにする
設備の改造、触媒の交換、原料や製品構成の変更があると、値どうしの関係が変わり、以前のモデルが合わなくなります。導入時にうまく動いていたモデルでも、数年たつと誤報が増えることは珍しくありません。
定修や設備改造のタイミングでモデルを見直すことを、保全計画の一部として決めておくと、精度を保ちやすくなります。
まとめ
- 故障予兆監視は、DCSの警報や定期点検より前の段階で、故障や運転異常の前ぶれを見つける仕組み
- 連続運転の損失の大きさ、設備の高経年化、人手不足、腐食による事故の多さが導入を後押ししている
- 監視の対象はプロセス・回転機・静機器の3つで、それぞれ使うデータと手法が異なる
- 手法はしきい値、MT法、回帰モデル、相関型AIがあり、対象と目的で使い分ける
- 成果を出すには、対象を絞って始め、検知後の対処手順とモデルの見直しまで運用に組み込むことが要になる
故障予兆監視は、計装やデータ分析の担当者だけでなく、運転と保全の現場が一緒に育てていく仕組みです。関連する職種は設備保全、技術テーマとしては予知保全がこのテーマと深く関わります。
プラントに関わる企業の全体像はプラント業界の企業の種類と仕事の流れで、化学メーカーの動向は化学・樹脂・ゴムの業種ページからあわせてご覧ください。
出典
出典・参考資料(12件)を開く出典・参考資料を閉じる
- 経年劣化による損失・予兆診断技術:日立評論「国内プラント設備の老朽化対策に寄与する予兆診断技術」(2022年)
- プラント保安の構造的課題・CBMによる開放検査周期:経済産業省「スマート保安推進に向けた取り組み」(消防庁 石油コンビナート等防災関係資料)
- AI信頼性評価ガイドライン・AI事例集:経済産業省「スマート保安」、日本規格協会「石油・化学プラントのAIを活用したスマート化を促すため、ガイドラインと事例集を策定」
- 高圧ガス事故等の件数・原因:神奈川県「異常現象及び高圧ガス事故等について(2024年発生状況、近年の傾向、注意喚起)」(2025年3月)
- モニタリング・診断技術の導入状況:消防庁 検討会資料「モニタリング技術・診断技術に対する調査について」
- 化学プラントの回転機診断:ジュンツウネット21「化学プラントにおける回転機設備診断機器の有効な活用法」
- PIシステム:横河技報「プラント情報システムPI」
- MT法:三菱重工業「MTシステム」
- 回帰モデル・相関型の異常予兆検知:azbil Technical Review「オンライン異常予兆検知システムの大規模プラント向け拡張機能の開発」(2024年)
- ENEOSの事例:ENEOSホールディングス ENEOSWAYS「劇的な変化を起こし続ける“製油所DX”<AI活用 前編>」(2026年4月8日)、ENEOS ニュースリリース「「Aspen Mtell」を活用した製油所における異常予兆検知を開始」(2025年3月3日、PR TIMES掲載)
- レゾナックの事例:DIGITAL X「半導体材料のレゾナック、プラントの異常を検知し運転員に解消策を知らせるシステムを稼働」(2024年)、レゾナック ニュースリリース「日立とレゾナック、大分コンビナートでデジタル化基盤構築」(2024年7月29日)
- 三井化学の運転支援AI:三井化学 ニュースリリース(2020年11月16日)
NEWSLETTER
選んだ職種・業種に合わせた記事を、週1回メールで
週刊MONOSCOPEは、登録時に選んだ職種・業種に合わせた記事を週1回お届けする無料のメルマガです。
職種・業種を選んで登録へ ›
無料・週1回。登録後に届く確認メールのリンクを押すと登録が完了します。配信はメール内のリンクからいつでも停止できます。
WEEKLY NEWS
今週の製造業ニュース10選
メルマガは職種・業種に合わせた記事。LINEとnoteでは、全員共通の10本を毎週土曜の朝にお届けします。
LINEでニュース10選を受け取るnote今週のニュース10選をnoteで読む ›
コメント